شروع تست

آموزش یادگیری ماشین با پایتون و R | از مقدماتی تا پیشرفته

در این دوره، یادگیری ماشین را به‌صورت کاربردی و پروژه‌محور یاد می‌گیرید؛ از آشنایی با مفاهیم پایه هوش مصنوعی تا ساخت، آموزش و ارزیابی مدل‌های Machine Learning با پایتون و R. با کار روی داده‌های واقعی، مهارت لازم برای تحلیل داده، انتخاب الگوریتم مناسب، بهینه‌سازی مدل‌ها و رسیدن به پیش‌بینی‌های دقیق‌تر را به دست می‌آورید.

۱۰۵۰۰+ دانشجو

تعداد دانشجویان دوره

۴۶ ساعت

مدت زمان دوره

مقدماتی تا پیشرفته

سطح دوره

گواهی‌نامه

اختصاصی گرولی

۴.۷

امتیاز دوره

آنچه در این دوره می‌آموزید:

محتوای دوره

فصل ۱: شروع مسیر یادگیری ماشین
شروع جذاب یادگیری ماشین: پیش‌بینی خرید خودرو با Python و Scikit-learn در کمتر از ۵ دقیقه
۰۴:۴۵
دریافت فایل‌های تمرینی، کدها، داده‌ها و اسلایدهای دوره
۰۰:۱۲
کارگاه‌ها و پیش‌نیازهای پیشنهادی پیش از شروع دوره
۰۱:۳۵
آموزش استفاده از Google Colab و فایل‌های دوره یادگیری ماشین
۰۵:۴۴
دانلود فایل‌ها و منابع موردنیاز دوره
۰۰:۰۳
آشنایی با بخش اول: آماده‌سازی و پیش‌پردازش داده‌ها
۰۰:۲۶
مراحل اجرای یک پروژه یادگیری ماشین؛ از ورود داده تا ساخت و ارزیابی مدل
۰۱:۳۱
تقسیم داده‌ها به مجموعه آموزش و تست و نقش آن در ارزیابی مدل‌های Machine Learning
۰۲:۰۲
مقیاس‌بندی ویژگی‌ها؛ بررسی تفاوت نرمال‌سازی و استانداردسازی داده‌ها
۰۶:۲۷
آماده‌سازی داده‌ها برای ساخت مدل‌های یادگیری ماشین
۰۵:۲۱
از داده خام تا داده آماده برای Machine Learning
۰۵:۲۱
آشنایی با ابزارهای اصلی: NumPy، Matplotlib و Pandas
۰۳:۳۴
وارد کردن Dataset با استفاده از read_csv در Pandas
۰۵:۱۳
انتخاب ویژگی‌ها با iloc در Pandas
۰۴:۴۲
ساخت متغیرهای X و Y برای آموزش مدل
۰۵:۴۶
مروری کوتاه بر برنامه‌نویسی شیءگرا در پایتون
۰۰:۵۴
تمرین ۱: وارد کردن و آماده‌سازی یک مجموعه داده
۰۶:۰۷
مدیریت مقادیر گمشده با Scikit-learn
۰۵:۵۶
جایگزینی Missing Values با SimpleImputer
۰۵:۵۸
تمرین ۲: مدیریت داده‌های گمشده در Dataset
۳۰:۲۷
تبدیل ویژگی‌های دسته‌ای با One-Hot Encoding
۰۴:۲۴
کار با One-Hot Encoding و ColumnTransformer
۰۵:۵۴
مقایسه One-Hot Encoding و Label Encoding
۰۴:۳۹
تمرین ۳: کدگذاری داده‌های دسته‌ای
۱۳:۲۷
آشنایی با Train Set و Test Set در یادگیری ماشین
۰۳:۵۵
ساخت مجموعه‌های آموزش و تست در پایتون
۰۵:۵۹
روش اصولی تقسیم داده‌ها به Train و Test
۰۳:۵۲
تمرین ۴: تقسیم داده‌ها و آماده‌سازی برای مقیاس‌بندی
۰۶:۰۱
چرا Feature Scaling در یادگیری ماشین اهمیت دارد؟
۰۵:۵۶
مقیاس‌بندی ویژگی‌های عددی در پایتون
۰۴:۴۵
کار با متدهای Fit و Transform در Scikit-learn
۰۳:۴۸
اعمال Scaler یکسان روی داده‌های آموزش و تست
۰۵:۵۹
تمرین ۵: پیاده‌سازی Feature Scaling
۱۱۹:۳۵
نصب R و RStudio در ویندوز و macOS و آماده‌سازی محیط کار
۰۵:۲۱
آشنایی با مراحل آماده‌سازی داده‌ها برای یادگیری ماشین
۰۱:۳۵
شناخت متغیرهای مستقل و وابسته در تحلیل داده
۰۱:۵۷
وارد کردن و بررسی Dataset در زبان R
۰۲:۴۴
مدیریت مقادیر گمشده در R برای پروژه‌های Machine Learning
۰۵:۵۵
کار با متغیرهای دسته‌ای با استفاده از تابع Factor در R
۰۵:۵۶
آشنایی با مجموعه‌های آموزش و تست در یادگیری ماشین
۰۴:۳۸
ساخت Train Set و Test Set در R
۰۴:۵۴
اهمیت Feature Scaling در آماده‌سازی داده‌ها
۰۴:۲۵
مقیاس‌بندی ویژگی‌های عددی در R
۰۴:۴۹
مرور مراحل اصلی پیش‌پردازش داده‌ها برای ساخت مدل‌های یادگیری ماشین
۰۵:۱۵
رگرسیون!
۰۰:۲۷
آشنایی با مفهوم رگرسیون خطی و انجام یک پیش‌بینی ساده
۰۲:۲۲
پیدا کردن بهترین خط برازش با روش حداقل مربعات (Ordinary Least Squares)
۰۳:۱۷
مفاهیم اصلی و مراحل پیاده‌سازی رگرسیون خطی ساده
۰۵:۴۹
آماده‌سازی و تقسیم داده‌ها برای رگرسیون خطی در Python
۰۵:۵۸
ساخت مدل Linear Regression با Scikit-learn در پایتون
۰۳:۵۳
آموزش و برازش مدل رگرسیون خطی در Python
۰۳:۵۸
پیش‌بینی مقادیر جدید با متد predict در Scikit-learn
۰۴:۳۵
نمایش بصری نتایج واقعی و پیش‌بینی‌شده مدل رگرسیون
۰۵:۴۹
بررسی عملکرد رگرسیون خطی روی داده‌های تست
۰۵:۵۷
مرور تکمیلی رگرسیون خطی ساده در Python
۰۰:۳۵
آماده‌سازی داده‌ها برای رگرسیون خطی در R
۰۴:۴۰
ساخت مدل رگرسیون خطی در R با تابع lm
۰۵:۵۸
انجام پیش‌بینی در R با تابع predict
۰۳:۳۸
بصری‌سازی نتایج رگرسیون خطی در R با ggplot2
۰۵:۴۴
رسم نمودار پراکندگی و خط رگرسیون با ggplot2
۰۵:۳۳
مقایسه پیش‌بینی مدل روی داده‌های آموزش و تست در R
۰۴:۳۷
پیش‌بینی موفقیت استارتاپ‌ها با مدل رگرسیون برای تصمیم‌گیری سرمایه‌گذاران VC
۰۳:۴۴
آشنایی با متغیرهای مستقل و نحوه عملکرد رگرسیون خطی چندگانه
۰۲:۲۶
بررسی فرض‌های اصلی رگرسیون خطی؛ از خطی بودن تا هم‌واری داده‌ها
۰۴:۲۳
مدیریت متغیرهای دسته‌ای در مدل‌های رگرسیون خطی
۰۷:۲۱
هم‌خطی چندگانه و مفهوم تله متغیرهای ساختگی (Dummy Variable Trap)
۰۲:۱۰
مفهوم P-Value و معنی‌داری آماری در آزمون فرض
۱۱:۴۵
انتخاب متغیرهای مؤثر با روش Backward Elimination
۱۵:۴۱
آماده‌سازی داده‌ها برای رگرسیون خطی چندگانه در Python
۰۵:۵۴
پیاده‌سازی اولیه Multiple Linear Regression در پایتون
۰۲:۳۵
پردازش و آماده‌سازی داده‌ها پیش از ساخت مدل رگرسیون
۰۴:۲۸
ساخت Dataset مناسب برای رگرسیون خطی چندگانه در Python
۰۴:۴۳
ساخت مدل رگرسیون چندگانه با Scikit-learn
۰۵:۵۲
آموزش مدل Multiple Linear Regression با Scikit-learn
۰۴:۳۲
مقایسه مقادیر واقعی و پیش‌بینی‌شده سود با مدل رگرسیون
۰۵:۳۸
ارزیابی دقت مدل رگرسیون خطی چندگانه در Python
۰۵:۳۴
حذف متغیرهای غیرضروری با Backward Elimination در پایتون
۰۱:۵۸
نکات تکمیلی رگرسیون خطی چندگانه در Python
۰۰:۴۱
آماده‌سازی داده‌های دسته‌ای برای Multiple Linear Regression در R
۰۳:۵۳
آماده‌سازی Dataset برای مدل رگرسیون چندگانه در R
۰۳:۵۷
ساخت مدل رگرسیون خطی چندگانه و تفسیر متغیرهای آن در R
۰۵:۲۲
تفسیر P-Value و سطوح معنی‌داری در خروجی مدل رگرسیون
۰۴:۲۰
پیش‌بینی مقادیر جدید با تابع predict در R
۰۴:۲۷
بهینه‌سازی مدل با روش Backward Elimination در R
۱۷:۵۱
انتخاب ویژگی‌های مؤثر با Backward Elimination در R
۰۷:۳۴
اجرای خودکار Backward Elimination برای رگرسیون خطی چندگانه در R
۰۰:۲۲
آشنایی با رگرسیون چندجمله‌ای، کاربردها و تفاوت آن با رگرسیون خطی
۰۵:۰۸
ساخت مدل Polynomial Regression برای پیش‌بینی حقوق در Python
۰۴:۳۶
آماده‌سازی داده‌ها برای مقایسه رگرسیون خطی و چندجمله‌ای
۰۵:۵۵
حرکت از Linear Regression به Polynomial Regression در پایتون
۰۵:۵۵
تبدیل ویژگی‌ها برای ساخت مدل رگرسیون چندجمله‌ای
۰۵:۴۳
بصری‌سازی مقادیر واقعی و پیش‌بینی‌های مدل رگرسیون خطی
۰۵:۵۷
مقایسه رگرسیون خطی و چندجمله‌ای و بررسی تأثیر درجه مدل
۰۵:۳۸
پیش‌بینی حقوق با مدل رگرسیون خطی در Python
۰۳:۵۹
انجام پیش‌بینی دقیق‌تر با Polynomial Regression در پایتون
۰۳:۵۹
پیاده‌سازی رگرسیون چندجمله‌ای در R با مثال تحلیل حقوق
۰۳:۴۵
آماده‌سازی داده‌ها برای Polynomial Regression در R
۰۳:۳۹
ساخت و مقایسه مدل‌های رگرسیون خطی و چندجمله‌ای در R
۰۴:۴۰
افزودن جملات درجه دوم و سوم به مدل رگرسیون چندجمله‌ای
۰۴:۵۵
نمایش نتایج رگرسیون با نمودارهای پراکندگی در ggplot2
۰۴:۵۹
بصری‌سازی پیش‌بینی‌های رگرسیون خطی در برابر داده‌های واقعی
۰۵:۳۱
رسم منحنی رگرسیون چندجمله‌ای و بررسی برازش بهتر مدل
۰۵:۴۲
پیش‌بینی یک مقدار جدید با Polynomial Regression در R
۰۳:۵۸
مثال عملی پیش‌بینی حقوق با رگرسیون چندجمله‌ای در R
۰۳:۴۷
ساخت یک چارچوب قابل استفاده مجدد برای رگرسیون غیرخطی در R
۰۵:۵۷
بهبود نمایش و تفسیر نتایج مدل‌های رگرسیون
۰۵:۲۵
آشنایی با SVR و تفاوت آن با رگرسیون خطی
۰۸:۰۹
مدل‌سازی روابط غیرخطی با SVR و کرنل RBF
۰۳:۵۷
آماده‌سازی داده‌ها و Feature Scaling برای مدل SVR در Python
۰۵:۴۶
وارد کردن کتابخانه‌ها و Dataset برای پیاده‌سازی SVR در پایتون
۰۳:۲۹
مقیاس‌بندی ویژگی‌ها برای رگرسیون بردار پشتیبان
۰۵:۳۴
تغییر شکل متغیر هدف Y برای انجام مقیاس‌بندی در SVR
۰۴:۵۶
مقیاس‌بندی جداگانه X و Y با StandardScaler
۰۳:۳۱
ساخت و آموزش مدل SVR با کرنل RBF در Python
۰۵:۵۷
پیش‌بینی با مدل SVR و بازگرداندن داده‌ها به مقیاس اصلی
۰۳:۴۶
بصری‌سازی نتایج مدل Support Vector Regression
۰۳:۴۲
کار با Scaling و Inverse Transform در مدل SVR
۰۳:۴۰
ساخت و آموزش مدل Support Vector Regression در R
۰۵:۵۸
انجام پیش‌بینی با مدل SVR و بررسی نتایج آن
۰۴:۵۸
آشنایی با ساخت درخت رگرسیون و منطق تصمیم‌گیری مدل
۱۱:۰۶
ساخت مدل Decision Tree Regression بدون نیاز به Feature Scaling
۰۴:۴۰
بارگذاری و آماده‌سازی داده‌ها برای درخت تصمیم در Python
۰۳:۵۸
پیاده‌سازی مدل DecisionTreeRegressor در پایتون
۰۴:۵۹
انجام پیش‌بینی با مدل رگرسیون درخت تصمیم
۰۳:۱۶
بصری‌سازی نتایج Decision Tree Regression با جزئیات بیشتر
۰۴:۵۹
ساخت مدل درخت تصمیم در R با استفاده از تابع rpart
۰۴:۵۵
تنظیم نحوه تقسیم گره‌ها با پارامترهای کنترلی rpart
۰۵:۴۹
بررسی ماهیت ناپیوسته پیش‌بینی‌ها در مدل‌های درخت تصمیم
۰۴:۵۵
تفسیر بازه‌های تصمیم و نمایش نتایج مدل درخت رگرسیون
۰۳:۵۰
آشنایی با الگوریتم Random Forest و کاربرد آن در یادگیری ماشین
۰۶:۴۴
پیاده‌سازی مدل Random Forest Regression با Scikit-learn در Python
۰۵:۵۳
تنظیم پارامترهای اصلی و آموزش رگرسور جنگل تصادفی
۰۵:۵۵
ساخت و آموزش مدل Random Forest Regression در R
۰۵:۵۱
بصری‌سازی نتایج جنگل تصادفی و بررسی ساختار پیش‌بینی‌ها
۰۵:۵۸
بهبود دقت مدل با افزایش تعداد درخت‌ها از ۱۰ به ۵۰۰
۰۵:۲۶
معیار R-Squared چیست و چگونه میزان برازش مدل رگرسیون را نشان می‌دهد؟
۰۴:۳۵
Adjusted R-Squared چیست و چه تفاوتی با R-Squared معمولی دارد؟
۰۵:۳۰
آماده‌سازی فایل‌ها و پوشه Model Selection برای شروع مقایسه مدل‌ها
۰۰:۳۲
مرور مدل‌های رگرسیون و مقایسه آن‌ها برای انتخاب عملکرد بهتر
۰۴:۴۵
ساخت قالب کد عمومی برای اجرای مدل‌های مختلف رگرسیون در Python
۰۵:۵۹
ارزیابی مدل‌های رگرسیون با R-Squared و سایر معیارهای عملکرد
۰۳:۵۹
محاسبه R-Squared در پایتون با متریک‌های Scikit-learn
۰۳:۵۸
انتخاب مدل رگرسیون مناسب بر اساس مقدار R-Squared
۰۴:۴۷
مقایسه عملکرد Random Forest و SVR برای انتخاب مدل بهتر
۰۴:۱۵
مقایسه R-Squared و Adjusted R-Squared برای ارزیابی بهتر مدل‌های رگرسیون
۰۸:۵۴
تفسیر ضرایب رگرسیون خطی و استفاده از نتایج در تصمیم‌گیری‌های کسب‌وکار
۰۹:۱۶
مرور و جمع‌بندی مباحث بخش رگرسیون
۰۰:۵۳
شروع بخش طبقه‌بندی و آشنایی با مسیر یادگیری
۰۰:۳۱
مفاهیم پایه Classification و کاربردهای آن در یادگیری ماشین
۰۲:۳۰
آشنایی با Logistic Regression و پیش‌بینی خروجی‌های دسته‌ای
۰۴:۵۵
یافتن منحنی برازش مناسب با روش Maximum Likelihood
۰۳:۵۰
ساخت مدل رگرسیون لجستیک برای پیش‌بینی رفتار مشتری
۰۵:۴۳
آماده‌سازی داده‌ها برای Logistic Regression در Python
۰۳:۵۹
پیش‌پردازش Dataset پیش از آموزش مدل رگرسیون لجستیک
۰۵:۵۱
مقیاس‌بندی ویژگی‌ها برای بهبود عملکرد Logistic Regression
۰۵:۵۷
استفاده از کلاس LogisticRegression در Scikit-learn
۰۳:۵۸
آموزش مدل طبقه‌بندی با متد fit
۰۳:۳۰
آماده‌سازی یک نمونه جدید برای پیش‌بینی با مدل لجستیک
۰۵:۵۹
مقایسه تصمیم‌های خرید واقعی و پیش‌بینی‌شده
۰۱:۴۹
بررسی خروجی‌های واقعی و پیش‌بینی‌شده مدل در Python
۰۵:۵۹
ساخت Confusion Matrix و محاسبه دقت با Scikit-learn
۰۵:۵۲
ارزیابی مدل طبقه‌بندی با ماتریس آشفتگی و معیارهای Accuracy
۰۳:۳۳
بصری‌سازی مرز تصمیم Logistic Regression در فضای دوبعدی
۰۵:۵۴
تفسیر نواحی تصمیم و خروجی‌های مدل رگرسیون لجستیک
۰۳:۴۴
نمایش عملکرد مدل روی داده‌های جدید در Python
۰۳:۱۹
آماده‌سازی داده‌ها برای Logistic Regression در R
۰۵:۵۹
ساخت طبقه‌بند رگرسیون لجستیک در R با تابع glm
۰۲:۵۹
انجام پیش‌بینی با مدل Logistic Regression در R
۰۵:۲۳
ارزیابی دقت مدل در R با استفاده از Confusion Matrix
۰۲:۴۸
نکته مهم و به‌روزرسانی مربوط به این بخش
۰۰:۴۳
تفسیر نمودارها و نواحی پیش‌بینی Logistic Regression
۰۵:۴۸
بررسی مرزهای تصمیم در طبقه‌بندهای خطی
۰۵:۵۹
بصری‌سازی نتایج رگرسیون لجستیک در R
۰۴:۵۹
ساخت قالب قابل استفاده مجدد برای مدل‌های طبقه‌بندی در R
۰۵:۲۲
تفاوت رگرسیون و طبقه‌بندی در یادگیری ماشین
۰۰:۲۴
مطالعه موردی تکمیلی برای Logistic Regression
۰۰:۱۷
آشنایی با الگوریتم KNN و نحوه استفاده از آن برای طبقه‌بندی داده‌ها
۰۴:۵۳
پیاده‌سازی KNN در Python برای دسته‌بندی مشتریان و بازاریابی هدفمند
۰۵:۵۸
ساخت مدل K-Nearest Neighbors با KNeighborsClassifier در Scikit-learn
۰۵:۵۱
بصری‌سازی مرزهای تصمیم مدل KNN در پایتون
۰۵:۵۸
آماده‌سازی داده‌ها و اجرای الگوریتم KNN در R
۰۵:۵۴
ساخت مدل KNN و آماده‌سازی داده‌های آموزش و تست در R
۰۴:۳۳
پیاده‌سازی و شخصی‌سازی قالب طبقه‌بندی KNN در R
۰۴:۴۴
آشنایی با SVM، مفهوم ابرصفحه و بردارهای پشتیبان در یادگیری ماشین
۰۹:۴۹
ساخت مدل Support Vector Machine با Scikit-learn در Python
۰۵:۵۸
پیاده‌سازی طبقه‌بند SVM با کلاس SVC در پایتون
۰۵:۵۳
بررسی محدودیت‌های SVM خطی و مقایسه عملکرد آن با KNN
۰۲:۳۹
آماده‌سازی داده‌ها و ساخت طبقه‌بند SVM خطی در R
۰۵:۴۷
انجام پیش‌بینی و ارزیابی عملکرد مدل SVM در R
۰۵:۲۷
عبور از SVM خطی به مدل‌های غیرخطی با نگاشت داده‌ها به فضای ابعاد بالاتر
۰۳:۱۷
تبدیل داده‌های غیرخطی برای ایجاد امکان جداسازی خطی در SVM
۰۷:۵۰
آشنایی با Kernel Trick و کاربرد آن در طبقه‌بندی غیرخطی
۱۲:۲۰
بررسی انواع Kernel و نقش آن‌ها در مدل‌های ماشین بردار پشتیبان
۰۲:۲۴
درک SVR غیرخطی و نحوه عملکرد کرنل RBF در رگرسیون بردار پشتیبان
۱۰:۵۵
پیاده‌سازی Kernel SVM با کرنل RBF در Python
۰۵:۵۹
بهبود عملکرد طبقه‌بندی با مدل‌های غیرخطی Kernel SVM
۰۵:۵۹
مقایسه SVM خطی و Kernel SVM برای داده‌های غیرخطی در R
۰۵:۴۲
ساخت طبقه‌بند SVM با کرنل گوسی (Gaussian/RBF Kernel)
۰۵:۴۱
بصری‌سازی مرزهای تصمیم Kernel SVM در مسائل طبقه‌بندی غیرخطی
۰۴:۵۸
آشنایی شهودی با قضیه بیز و نقش احتمال در یادگیری ماشین
۲۰:۲۵
درک الگوریتم Naive Bayes و منطق طبقه‌بندی احتمالاتی
۱۴:۰۳
محاسبه مرحله‌به‌مرحله احتمال با استفاده از قضیه بیز
۰۶:۰۴
چرا این الگوریتم «بیز ساده» نام دارد؟ بررسی فرض استقلال ویژگی‌ها
۰۹:۴۱
پیاده‌سازی Naive Bayes در Python با مثال تبلیغات شبکه‌های اجتماعی
۰۵:۵۶
آموزش و ارزیابی مدل Naive Bayes روی داده‌های واقعی در پایتون
۰۵:۴۸
بررسی دقت و تحلیل پیش‌بینی‌های مدل بیز ساده
۰۱:۳۵
آماده‌سازی داده‌ها و اجرای الگوریتم Naive Bayes در R
۰۴:۵۳
رفع خطاهای مربوط به خروجی و بردارهای پیش‌بینی در مدل Naive Bayes
۰۴:۴۱
ارزیابی و بصری‌سازی نتایج با Confusion Matrix و نمودارهای طبقه‌بندی
۰۳:۲۹
آشنایی با نحوه عملکرد درخت تصمیم و منطق تقسیم داده‌ها در مسائل طبقه‌بندی
۰۸:۰۸
پیاده‌سازی Decision Tree Classification با Scikit-learn در Python
۰۵:۵۹
آموزش و تنظیم مدل درخت تصمیم برای بهبود عملکرد طبقه‌بندی
۰۵:۵۶
ساخت مدل Decision Tree در R با استفاده از کتابخانه rpart
۰۵:۵۵
بهینه‌سازی مرزهای تصمیم و پیش‌بینی مدل درخت تصمیم در R
۰۵:۵۱
بصری‌سازی ساختار درخت، تقسیم‌ها و شرایط تصمیم‌گیری در R
۰۵:۴۲
آشنایی با Random Forest، ترکیب چند درخت تصمیم و رأی‌گیری نهایی مدل
۰۴:۲۸
پیاده‌سازی Random Forest Classification با Scikit-learn در Python
۰۵:۵۶
ارزیابی مدل با Confusion Matrix و معیارهای دقت طبقه‌بندی
۰۵:۵۶
ساخت و اجرای مدل Random Forest Classification در R
۰۵:۵۶
بصری‌سازی پیش‌بینی‌ها و بررسی نتایج مدل جنگل تصادفی
۰۵:۵۸
تحلیل عملکرد روی داده‌های تست و بررسی پدیده Overfitting
۰۵:۲۶
آماده‌سازی فایل‌ها و پوشه Model Selection برای مقایسه مدل‌ها
۰۰:۳۲
درک Confusion Matrix؛ بررسی True Positive، True Negative و خطاهای مدل
۰۴:۵۲
انتخاب الگوریتم طبقه‌بندی مناسب بر اساس ویژگی‌های Dataset
۰۵:۵۱
بهینه‌سازی کد برای مقایسه مدل‌های مختلف Classification در Python
۰۵:۵۹
ارزیابی الگوریتم‌های طبقه‌بندی با معیارهای دقت در پایتون
۰۵:۵۲
مقایسه نهایی مدل‌ها و انتخاب بهترین الگوریتم طبقه‌بندی
۰۲:۳۸
تحلیل پیش‌بینی‌ها و خطاهای مدل Logistic Regression در مسائل طبقه‌بندی
۰۷:۵۷
چرا Accuracy همیشه کافی نیست؟ آشنایی با معیارهای بهتر ارزیابی مدل
۰۲:۱۲
آشنایی با منحنی CAP و کاربرد آن در سنجش عملکرد مدل‌های طبقه‌بندی
۱۱:۱۶
تحلیل منحنی CAP و ارزیابی مدل با Accuracy Ratio
۰۶:۱۹
مرور و جمع‌بندی مباحث بخش Classification
۰۲:۱۲
خوشه بندی (Clustering)
۰۰:۲۹
آشنایی با Clustering و مفهوم یادگیری بدون نظارت (Unsupervised Learning)
۰۳:۱۹
درک نحوه عملکرد الگوریتم K-Means و فرآیند تشکیل خوشه‌ها
۰۲:۳۷
انتخاب تعداد مناسب خوشه‌ها با روش Elbow
۰۳:۵۹
آشنایی با K-Means++ و بهبود مقداردهی اولیه مراکز خوشه‌ها
۰۴:۴۸
پیاده‌سازی K-Means در Python برای شناسایی الگوهای رفتاری مشتریان
۰۴:۵۹
آماده‌سازی داده‌ها برای خوشه‌بندی در Google Colab و Jupyter
۰۲:۵۸
انتخاب ویژگی‌های مناسب برای تحلیل خوشه‌ای در پایتون
۰۴:۵۵
آماده‌سازی ویژگی‌ها برای نمایش دوبعدی نتایج K-Means
۰۲:۲۵
پیاده‌سازی Elbow Method برای پیدا کردن تعداد بهینه خوشه‌ها
۰۵:۵۹
محاسبه WCSS و بهینه‌سازی تعداد خوشه‌های K-Means
۰۵:۵۷
رسم نمودار Elbow و تفسیر نقطه بهینه در Python
۰۳:۵۸
تبدیل نتایج خوشه‌بندی به برچسب‌های قابل استفاده برای تحلیل داده‌ها
۰۵:۵۸
بصری‌سازی خوشه‌های مشتریان با نمودار Scatter در پایتون
۰۵:۵۹
نمایش بخش‌های مختلف مشتریان بر اساس نتایج K-Means
۰۴:۵۷
تحلیل رفتار مشتریان و استخراج بینش از خوشه‌های ایجادشده
۰۶:۵۹
وارد کردن و بررسی داده‌ها برای K-Means Clustering در R
۰۵:۵۹
ساخت مدل K-Means در R و تحلیل داده‌های بخش‌بندی مشتریان
۰۵:۳۹
آشنایی با خوشه‌بندی سلسله‌مراتبی و مراحل اجرای آن در یادگیری ماشین
۰۸:۴۷
نمایش ساختار خوشه‌ها با نمودار درختی Dendrogram
۰۸:۴۸
تحلیل Dendrogram و تعیین آستانه مناسب برای انتخاب تعداد خوشه‌ها
۱۱:۲۱
آماده‌سازی داده‌ها برای Hierarchical Clustering در Python
۰۵:۵۸
ساخت Dendrogram با استفاده از کتابخانه SciPy در پایتون
۰۴:۵۲
بصری‌سازی ساختار خوشه‌ها و ارتباط داده‌ها در نمودار درختی
۰۵:۵۸
تفسیر Dendrogram و پیدا کردن تعداد بهینه خوشه‌ها
۰۵:۵۹
ساخت مدل Hierarchical Clustering با Scikit-learn در Python
۰۵:۴۵
مقایسه نتایج مدل با ۳ و ۵ خوشه در پایتون
۰۵:۴۲
وارد کردن و آماده‌سازی داده‌های مشتریان برای خوشه‌بندی در R
۰۳:۴۵
ساخت و تفسیر Dendrogram با تابع hclust در R
۰۵:۲۳
پیاده‌سازی مدل خوشه‌بندی سلسله‌مراتبی و تخصیص داده‌ها به خوشه‌ها در R
۰۳:۱۸
بصری‌سازی نتایج Hierarchical Clustering در R
۰۲:۴۵
تحلیل الگوهای رفتاری و میزان هزینه‌کرد مشتریان با خوشه‌بندی سلسله‌مراتبی
۰۲:۳۳
یادگیری قوانین انجمنی (Association Rule Learning)
۰۰:۱۷
آشنایی با الگوریتم Apriori و کشف الگوهای پنهان در داده‌های تراکنشی
۱۸:۱۳
استفاده از Association Rule Learning برای تحلیل رفتار خرید و افزایش فروش
۰۸:۴۶
ساخت فهرست تراکنش‌ها برای تحلیل سبد خرید در Python
۱۷:۰۷
تنظیم پارامترهای Support، Confidence و Lift در الگوریتم Apriori
۱۲:۴۸
تحلیل و بصری‌سازی قوانین استخراج‌شده برای پیشنهاد محصولات
۱۹:۴۱
ساخت Sparse Matrix برای استخراج قوانین انجمنی در R
۱۹:۵۳
تنظیم حداقل Support و Confidence برای بهینه‌سازی مدل Apriori
۱۴:۲۵
تحلیل Lift و Confidence برای بهبود چیدمان و پیشنهاد محصولات
۱۹:۱۸
آشنایی با الگوریتم Eclat و استخراج مجموعه آیتم‌های پرتکرار بر اساس Support
۰۶:۰۵
تبدیل رویکرد Apriori به Eclat برای تحلیل کارآمدتر تراکنش‌ها در Python
۱۲:۰۰
مقایسه Eclat و Apriori و بررسی تفاوت آن‌ها در Association Rule Learning
۱۰:۰۹
یادگیری تقویتی (Reinforcement Learning)
۰۰:۴۹
آشنایی با مسئله Multi-Armed Bandit و تعادل میان Exploration و Exploitation
۱۵:۳۶
درک الگوریتم UCB و کاربرد آن برای حل مسئله چندبازویی
۱۴:۵۳
حل مسئله Multi-Armed Bandit با الگوریتم UCB در Python
۱۲:۴۲
آماده‌سازی داده‌ها برای پیاده‌سازی Upper Confidence Bound در پایتون
۰۳:۵۱
تعریف متغیرهای اصلی و منطق محاسباتی الگوریتم UCB
۰۷:۱۶
پیاده‌سازی مرحله‌به‌مرحله الگوریتم UCB در Python
۱۵:۴۵
بهینه‌سازی انتخاب تبلیغات با استفاده از Upper Confidence Bound
۰۶:۱۲
تکمیل الگوریتم UCB و بررسی فرآیند انتخاب بهینه
۰۷:۲۸
بصری‌سازی نتایج UCB و تحلیل انتخاب‌ها با نمودار Histogram
۰۸:۰۹
پیاده‌سازی الگوریتم UCB در R برای مسئله Multi-Armed Bandit
۱۳:۳۹
محاسبه میانگین پاداش و بازه اطمینان در الگوریتم UCB با R
۱۵:۵۸
بهینه‌سازی انتخاب تبلیغات و تحلیل منطق تصمیم‌گیری UCB
۱۷:۳۸
ارزیابی عملکرد الگوریتم UCB با تحلیل نمودارهای Histogram
۰۳:۱۸
آشنایی با Thompson Sampling و منطق تصمیم‌گیری احتمالاتی آن
۱۹:۱۲
مقایسه الگوریتم‌های قطعی و احتمالاتی؛ UCB در برابر Thompson Sampling
۰۸:۱۲
پیاده‌سازی Thompson Sampling برای مسئله Multi-Armed Bandit در Python
۰۵:۴۷
بهینه‌سازی انتخاب تبلیغات با الگوریتم نمونه‌برداری تامپسون
۱۲:۱۹
کار با توزیع Beta و انتخاب گزینه بهینه در Thompson Sampling
۱۴:۰۳
مقایسه عملکرد Thompson Sampling و UCB در مسائل چندبازویی
۰۷:۴۵
منبع و محتوای تکمیلی این بخش
۰۰:۵۴
مقایسه Thompson Sampling و UCB برای بهینه‌سازی نرخ کلیک در R
۱۹:۰۱
تحلیل عملکرد Thompson Sampling در مقایسه با الگوریتم UCB
۰۳:۲۷
آغاز بخش پردازش زبان طبیعی و آشنایی با مسیر یادگیری
۰۱:۰۱
آشنایی با مفاهیم پایه NLP و مدل Bag of Words
۰۳:۰۲
بررسی نقش یادگیری عمیق و مدل‌های Sequence-to-Sequence در پردازش زبان طبیعی
۰۴:۱۱
مروری بر تحول NLP؛ از قواعد ساده تا شبکه‌های عصبی کانولوشنی
۱۱:۲۲
پیاده‌سازی مرحله‌به‌مرحله مدل Bag of Words
۱۷:۰۵
شروع پروژه تحلیل احساسات (Sentiment Analysis)
۰۷:۱۳
وارد کردن داده‌های TSV برای تحلیل احساسات در Python
۰۶:۴۵
پاک‌سازی متن؛ حذف علائم نگارشی و یکسان‌سازی حروف
۱۲:۵۴
پیش‌پردازش متن با Stemming و حذف Stop Words در پایتون
۱۱:۰۰
توکن‌سازی و استخراج ویژگی‌ها برای تحلیل احساسات با Naive Bayes
۱۷:۲۴
آموزش و ارزیابی مدل Naive Bayes برای Sentiment Analysis
۰۹:۵۲
مطالب تکمیلی پردازش زبان طبیعی در Python
۰۰:۳۱
تمرین عملی این بخش
۰۰:۵۰
طبقه‌بندی متن با Bag of Words و Random Forest در R
۱۶:۳۵
نکته مهم و به‌روزرسانی این بخش
۰۰:۲۳
وارد کردن فایل‌های TSV و آماده‌سازی داده‌های NLP در R
۰۸:۳۹
ساخت Corpus برای تحلیل و پردازش متون در R
۰۶:۲۸
یکسان‌سازی حروف برای پاک‌سازی داده‌های متنی
۰۲:۵۸
حذف اعداد از متن با ابزارهای بسته tm در R
۰۲:۰۵
حذف علائم نگارشی برای آماده‌سازی داده‌های متنی
۰۵:۴۹
حذف Stop Words با SnowballC و ساده‌سازی Corpus
۰۳:۲۷
استفاده از Stemming برای بهبود ویژگی‌های متنی
۰۵:۲۰
حذف فاصله‌های اضافی و تکمیل فرآیند پاک‌سازی متن
۱۲:۵۰
ساخت Document-Term Matrix برای طبقه‌بندی متن در NLP
۱۷:۳۱
تمرین عملی پردازش زبان طبیعی در R
۰۰:۵۵
آغاز بخش یادگیری عمیق و آشنایی با مسیر آموزشی
۰۰:۳۳
مقدمه‌ای بر Deep Learning؛ از شکل‌گیری اولیه تا کاربردهای امروزی
۱۲:۳۴
آشنایی اولیه با ساختار شبکه‌های عصبی و لایه‌های اصلی آن‌ها
۰۲:۵۲
مبانی شبکه عصبی؛ نورون‌ها، ارتباطات و توابع فعال‌سازی
۱۶:۲۵
آشنایی با Activation Functionها و نقش آن‌ها در یادگیری عمیق
۰۸:۲۹
شبکه عصبی چگونه داده‌ها را پردازش و خروجی تولید می‌کند؟
۱۲:۴۷
فرآیند یادگیری در شبکه‌های عصبی و به‌روزرسانی وزن‌ها
۱۲:۵۹
آشنایی با Gradient Descent و تفاوت آن با روش‌های جست‌وجوی مستقیم
۱۰:۱۳
مقایسه Stochastic Gradient Descent و Batch Gradient Descent
۰۸:۴۴
مراحل آموزش یک شبکه عصبی از ابتدا تا بهینه‌سازی مدل
۰۵:۲۲
پروژه پیش‌بینی ریزش مشتریان بانک با TensorFlow
۰۴:۵۹
ساخت شبکه عصبی مصنوعی در Python برای پیش‌بینی Churn مشتریان
۱۰:۲۱
پیش‌پردازش داده‌ها برای مدل شبکه عصبی با TensorFlow ۲
۱۸:۳۶
طراحی ANN با مدل Sequential و لایه‌های Dense
۱۴:۲۸
کامپایل و آموزش شبکه عصبی با متد fit در TensorFlow
۱۱:۵۸
پیش‌بینی ریزش مشتری و ارزیابی ANN با Confusion Matrix
۱۶:۲۵
آماده‌سازی داده‌ها برای شبکه عصبی مصنوعی در R
۱۷:۱۷
نصب و راه‌اندازی H2O برای اجرای مدل‌های Deep Learning در R
۰۶:۳۰
ساخت و پیکربندی شبکه عصبی با H2O
۱۲:۲۹
انجام پیش‌بینی و ارزیابی دقت مدل Deep Learning در R
۱۴:۰۷
مطالب تکمیلی یادگیری عمیق
۰۰:۲۹
مطالعه موردی تکمیلی شبکه عصبی مصنوعی (ANN)
۰۰:۲۰
آشنایی با اجزای اصلی CNN؛ Convolution، ReLU، Pooling و Flattening
۰۳:۳۱
مقدمه‌ای بر شبکه‌های عصبی کانولوشنی و کاربرد آن‌ها در بینایی ماشین
۱۵:۴۹
عملیات Convolution؛ استخراج ویژگی‌ها و ساخت Feature Map در CNN
۱۶:۳۸
استفاده از تابع ReLU برای افزودن رفتار غیرخطی به شبکه کانولوشنی
۰۶:۴۱
آشنایی با Max Pooling و نقش آن در استخراج ویژگی‌های مهم تصویر
۱۴:۱۳
تبدیل Feature Mapها به بردار با فرآیند Flattening
۰۱:۵۲
کار با لایه‌های Fully Connected و ترکیب ویژگی‌های استخراج‌شده
۱۹:۲۵
شبکه CNN چگونه تصاویر را پردازش و طبقه‌بندی می‌کند؟
۰۴:۱۹
آشنایی با Softmax و Cross-Entropy در مدل‌های طبقه‌بندی تصویر
۱۸:۲۰
آماده‌سازی Dataset موردنیاز برای پروژه شبکه عصبی کانولوشنی
۰۰:۲۱
ساخت CNN برای مسئله طبقه‌بندی تصاویر
۱۱:۳۵
استفاده از ImageDataGenerator در Keras برای کاهش Overfitting
۱۷:۴۶
ساخت معماری CNN در TensorFlow؛ از لایه Convolution تا خروجی مدل
۱۷:۵۶
آموزش مدل CNN؛ تنظیم Epoch، Loss Function و Metrics در TensorFlow
۰۷:۲۱
انجام پیش‌بینی روی یک تصویر جدید با CNN در Python
۱۴:۵۵
پروژه عملی طبقه‌بندی تصاویر با CNN در Jupyter Notebook
۲۳:۳۸
مطالب تکمیلی بخش یادگیری عمیق و CNN
۰۰:۲۷
کاهش ابعاد
۰۰:۳۸
آشنایی شهودی با PCA و نقش آن در کاهش ابعاد داده‌ها
۰۳:۴۹
پیاده‌سازی PCA در Python برای کاهش ویژگی‌های Dataset با Scikit-learn
۱۶:۵۲
کاهش ابعاد داده و استفاده از مؤلفه‌های اصلی برای تحلیل و پیش‌بینی
۰۵:۳۰
درک مفهوم Principal Component Analysis و استخراج ویژگی‌ها در R
۱۲:۰۸
اجرای PCA با تابع preProcess و استخراج مؤلفه‌های اصلی در R
۱۱:۲۲
ترکیب PCA و SVM برای بخش‌بندی و تحلیل داده‌ها در یک پروژه عملی
۱۳:۴۲
آشنایی شهودی با LDA و مفهوم بیشینه‌سازی فاصله میان کلاس‌ها
۰۳:۵۰
پیاده‌سازی مرحله‌به‌مرحله Linear Discriminant Analysis در Python
۱۴:۵۲
استفاده از LDA برای استخراج ویژگی و کاهش ابعاد در مسائل طبقه‌بندی
۱۹:۵۹
پیاده‌سازی Kernel PCA در Python برای استخراج ویژگی و بهبود عملکرد طبقه‌بندی
۱۱:۰۳
استفاده از Kernel PCA برای کاهش ابعاد داده‌های غیرخطی به‌صورت مرحله‌به‌مرحله
۲۰:۳۰
انتخاب مدل و بوستینگ
۰۰:۳۳
آشنایی با K-Fold Cross-Validation و ارزیابی مطمئن‌تر عملکرد مدل
۰۸:۵۸
درک Bias-Variance Tradeoff و ایجاد تعادل میان کم‌برازش و بیش‌برازش
۰۴:۴۷
پیاده‌سازی K-Fold Cross-Validation در Python برای ارزیابی دقیق‌تر مدل
۱۳:۴۵
بهینه‌سازی پارامترهای مدل SVM با GridSearchCV در پایتون
۲۱:۵۶
اجرای K-Fold Cross-Validation در R برای سنجش دقت مدل
۱۹:۲۹
تنظیم و بهینه‌سازی پارامترهای SVM با Grid Search در R
۱۳:۵۹
استفاده از XGBoost در Python برای ساخت مدل دقیق پیش‌بینی سرطان
۱۴:۴۸
مطالب تکمیلی درباره انتخاب مدل و الگوریتم‌های Boosting
۰۰:۳۷
پیاده‌سازی XGBoost و Gradient Boosting برای مسائل طبقه‌بندی
۱۸:۱۴
درک شهودی رگرسیون لجستیک
۱۷:۰۶

پیش نمایش دوره

نظرات دانشجویان دوره

۴.۷

به این میگن دوره صفر تا صد…عالی!

حمید مهدی پور لیاولی

خیلی خوبه، یه جاهایی میتونیم برای عمیق شدن دانش خودمون مطالعات بیشتری داشته باشیم (که الزامی نیست) ولی در کل خیلی انرژی میگیرم ازش و خسته نمیشم.

دانشجوی دوره

مدرسین این دوره بسیار مسلط هستند و مباحث پیچیده را به شکلی ساده شده منتقل میکنند.

مجتبی بخشی مالدار

بهترین دوره ای که میتونید پیدا کنید.

دانشجوی دوره

برای شروع خوبه و خیلی ساده و قابل فهم توضیح میده.

حامد صحرائی

فوق العاده عالی و کاربردی.

حسین قلی پور

دوره فوق العاده و بی نقص.

سینا سبحانی نیکو

مدرسان دوره

growly

آکادمی گرولی

• آکادمی گرولی با هدف توانمندسازی و توسعه‌ی حرفه‌ای افراد فعالیت می‌کند.
• دوره‌های این آکادمی در حوزه‌های شغلی متنوعی مانند هوش مصنوعی، برنامه‌نویسی، نرم‌افزارهای کاربردی، مدیریت محصول، بازاریابی دیجیتال، مهارت‌های نرم و توسعه کسب‌وکار دسته‌بندی می‌شوند.

این دوره‌ها اکثرا از پرفروش‌ترین آموزش‌های برترین پلتفرم‌های یادگیری دنیا مانند یودمی، لینکدین‌لرنینگ، کورسرا و ریفورج هستند که همگی با زیرنویس فارسی منتشر شده‌اند. همچنین چندی از دوره‌های این آکادمی نیز، به صورت اختصاصی توسط مدرسان معتبر ایرانی تهیه گردیده‌اند.

Kirill Eremenko

Kirill Eremenko

فعالیت حرفه‌ای من در حوزه مشاوره علم داده شکل گرفت و در طول این مسیر، با پروژه‌ها و مسائل متنوعی در صنایعی مانند مالی، خرده‌فروشی، حمل‌ونقل و دیگر حوزه‌های کسب‌وکار کار کرده‌ام. بخشی از مسیر حرفه‌ای من نیز با آموزش‌های تخصصی در Deloitte استرالیا همراه بوده؛ جایی که فرصت داشتم زیر نظر متخصصان حوزه تحلیل داده مهارت‌های خود را توسعه دهم. پس از آغاز فعالیت آموزشی در Udemy، این تجربه‌ها و آموخته‌ها را با هزاران علاقه‌مند به علم داده به اشتراک گذاشته‌ام.

در دوره‌های من تلاش می‌کنم تجربه‌های واقعی بازار کار را با دانش آکادمیکم در فیزیک و ریاضیات ترکیب کنم تا مفاهیم علم داده به‌صورت مرحله‌به‌مرحله، کاربردی و قابل فهم آموزش داده شوند. تمرکز اصلی سبک آموزشی من روی درک شهودی مفاهیم است؛ به همین دلیل حتی موضوعات پیچیده نیز با مثال‌ها و توضیحاتی ارائه می‌شوند که یادگیری آن‌ها ساده‌تر و عمیق‌تر باشد.

علم داده برای من فقط یک زمینه تخصصی نیست، بلکه حوزه‌ای است که به آن علاقه جدی دارم. هدفم این است که این تجربه و دانش را به شکلی کاربردی منتقل کنم تا بتوانید مفاهیم را بهتر درک کرده و در پروژه‌های واقعی از آن‌ها استفاده کنید.

Hadelin de Ponteves

Hadelin de Ponteves

هادلین یک کارآفرین و مدرس آنلاین است که بیش از ۳۰ دوره آموزشی در حوزه فناوری‌های نوظهور از جمله هوش مصنوعی، یادگیری ماشین، یادگیری عمیق، بلاک‌چین و ارزهای دیجیتال منتشر کرده است. تمرکز اصلی او بر ساده‌سازی مفاهیم تخصصی و انتقال دانش کاربردی به علاقه‌مندان در سراسر جهان است.

دوره‌های آموزشی او تاکنون با استقبال گسترده‌ای روبه‌رو شده‌اند و بیش از ۲ میلیون زبان‌آموز در آن‌ها ثبت‌نام کرده‌اند. هدف هادلین این است که یادگیری فناوری‌های جدید را برای افراد بیشتری در دسترس قرار دهد و به آن‌ها کمک کند مهارت‌های کاربردی و به‌روزتری به دست آورند.

SuperDataScience Team

SuperDataScience Team

تیم SuperDataScience از جمعی از متخصصان، مدرس‌ها و فعالان حوزه علم داده و هوش مصنوعی تشکیل شده است که با تولید دوره‌های آموزشی، پادکست، مقاله و منابع تکمیلی، به یادگیری مهارت‌های مرتبط با فناوری‌های نوین کمک می‌کنند.

رویکرد آموزشی این تیم بر ترکیب تجربه عملی در صنعت با آموزش مرحله‌به‌مرحله استوار است تا موضوعات پیچیده‌ای مانند علم داده، یادگیری ماشین و هوش مصنوعی به شکلی ساده‌تر، کاربردی‌تر و قابل فهم ارائه شوند. هدف SuperDataScience این است که علاقه‌مندان بتوانند مهارت‌های خود را توسعه دهند و همگام با تغییرات سریع دنیای فناوری پیش بروند.
Ligency Team

Ligency Team

تیم روابط عمومی و بازاریابی Ligency تلاش می‌کند تازه‌ترین محتوای آموزشی و منابع کاربردی این مجموعه را در اختیار علاقه‌مندان قرار دهد. با انتشار دوره‌های جدید، قسمت‌های تازه پادکست، مقالات تخصصی، Cheatsheetها و سایر منابع آموزشی، جدیدترین مطالب Ligency با مخاطبان به اشتراک گذاشته می‌شود.

هدف این تیم کمک به یادگیری مستمر و آشنایی مخاطبان با تازه‌ترین موضوعات و مهارت‌های حوزه علم داده و فناوری است تا بتوانند دانش خود را همگام با تغییرات این حوزه توسعه دهند.

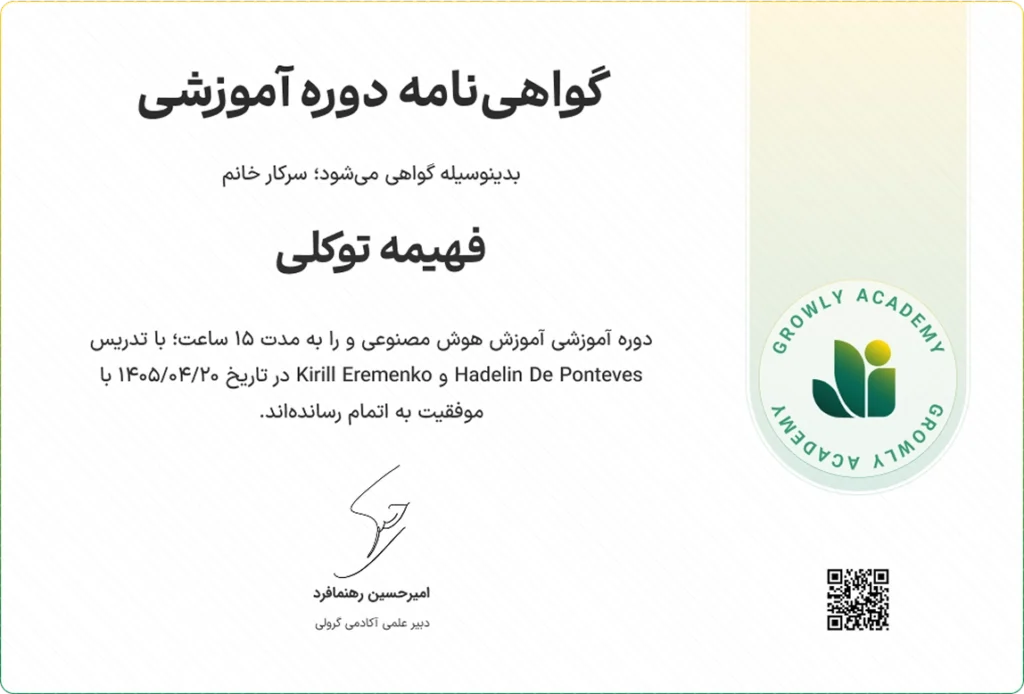
گواهی‌نامه دوره

اگر بیش از ۹۰٪ دوره را گذرانده باشید، می‌توانید با ارسال اسکرین‌شاتِ بخش پیشرفت دوره برای پشتیبانی، گواهی‌نامه گرولی را دریافت کنید.

سوالات پرتکرار

آیا در صورت خرید دوره، گواهی‌نامه آن به من تعلق می‌گیرد؟

خیر، در صورت تکمیل دوره گواهی‌نامه به شما تعلق می‌گیرد.

بله. پس از پایان مدت دوره نیز به ویدئوها، تمرین‌ها، پروژه‌ها و سایر محتوای آموزشی دوره دسترسی خواهید داشت.

بله.


خیر، این دوره به پیش‌نیازی احتیاج ندارد.

 از طریق مکتب‌خونه به محتوای دوره دسترسی خواهید داشت.‍

 می‌توانید در کامیونیتی گرولی مطرح کنید.

کامیونیتی تلگرام
کامیونیتی بله

 از سیاست بازگشت وجه مکتب‌خونه پیروی می‌کند.

پیش نمایش دوره

دوره ابزارهای مدیریت محصول